Proyectos / Productos y herramientas
Agente 10-K
Responde sobre informes de la SEC
Resumen
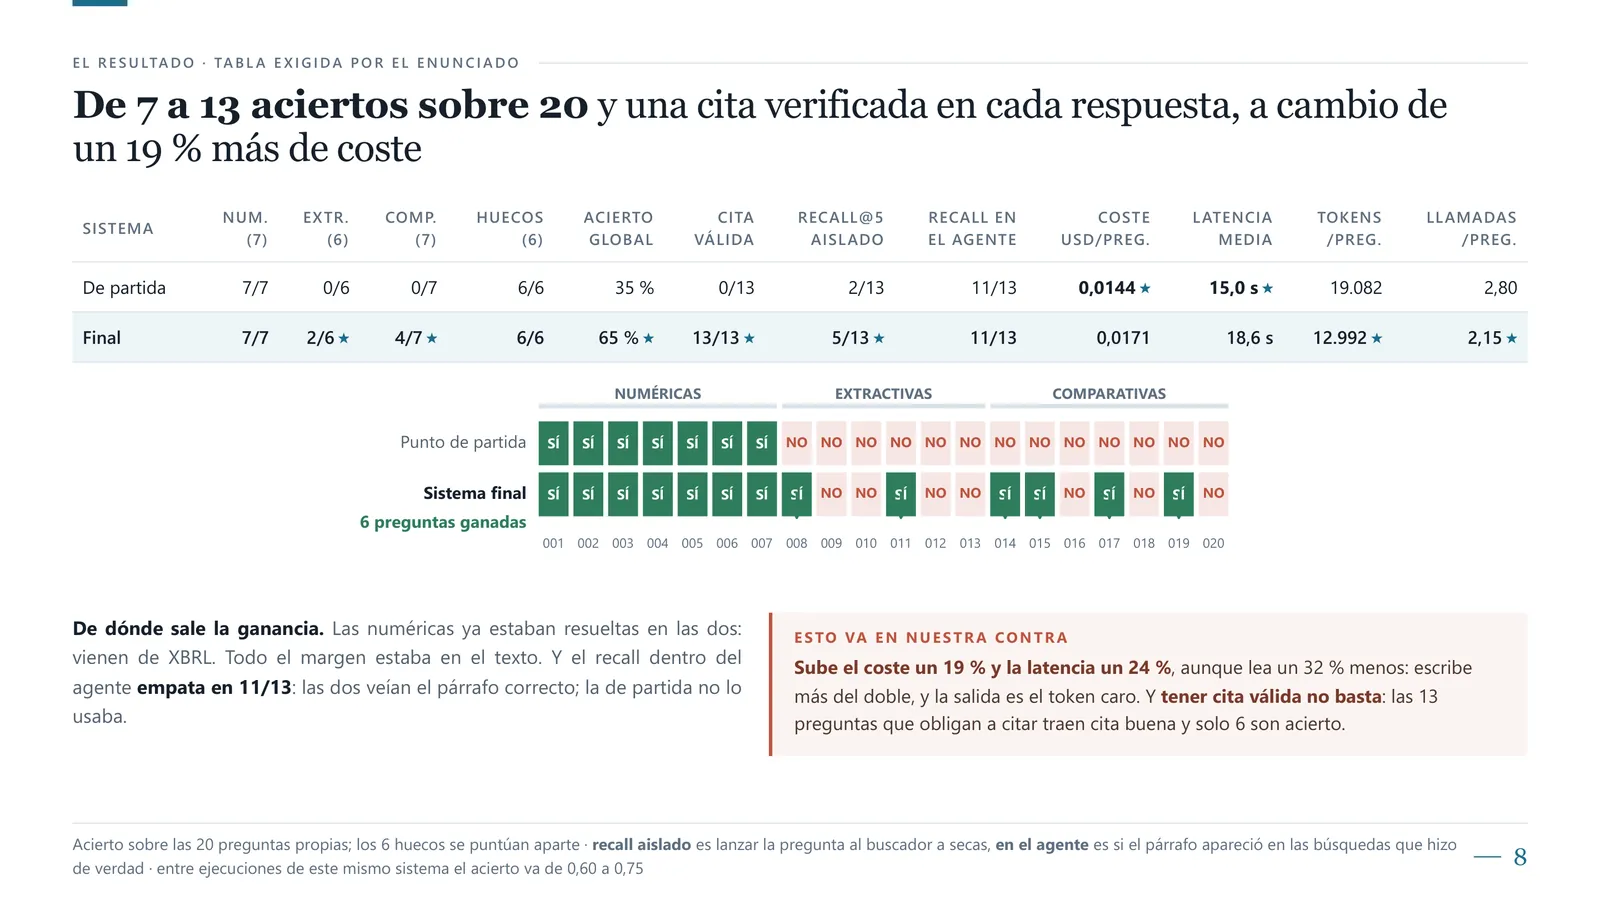
Responde preguntas financieras sobre informes 10-K, cita la fuente exacta y comprueba cada cifra contra XBRL, con una búsqueda que combina vectores y BM25. El acierto pasó del 35 % al 65 % frente a la versión base, y acertó 8 de 10 preguntas a ciegas. Equipo de 3.
LangGraph, FAISS y BM25.
El problema
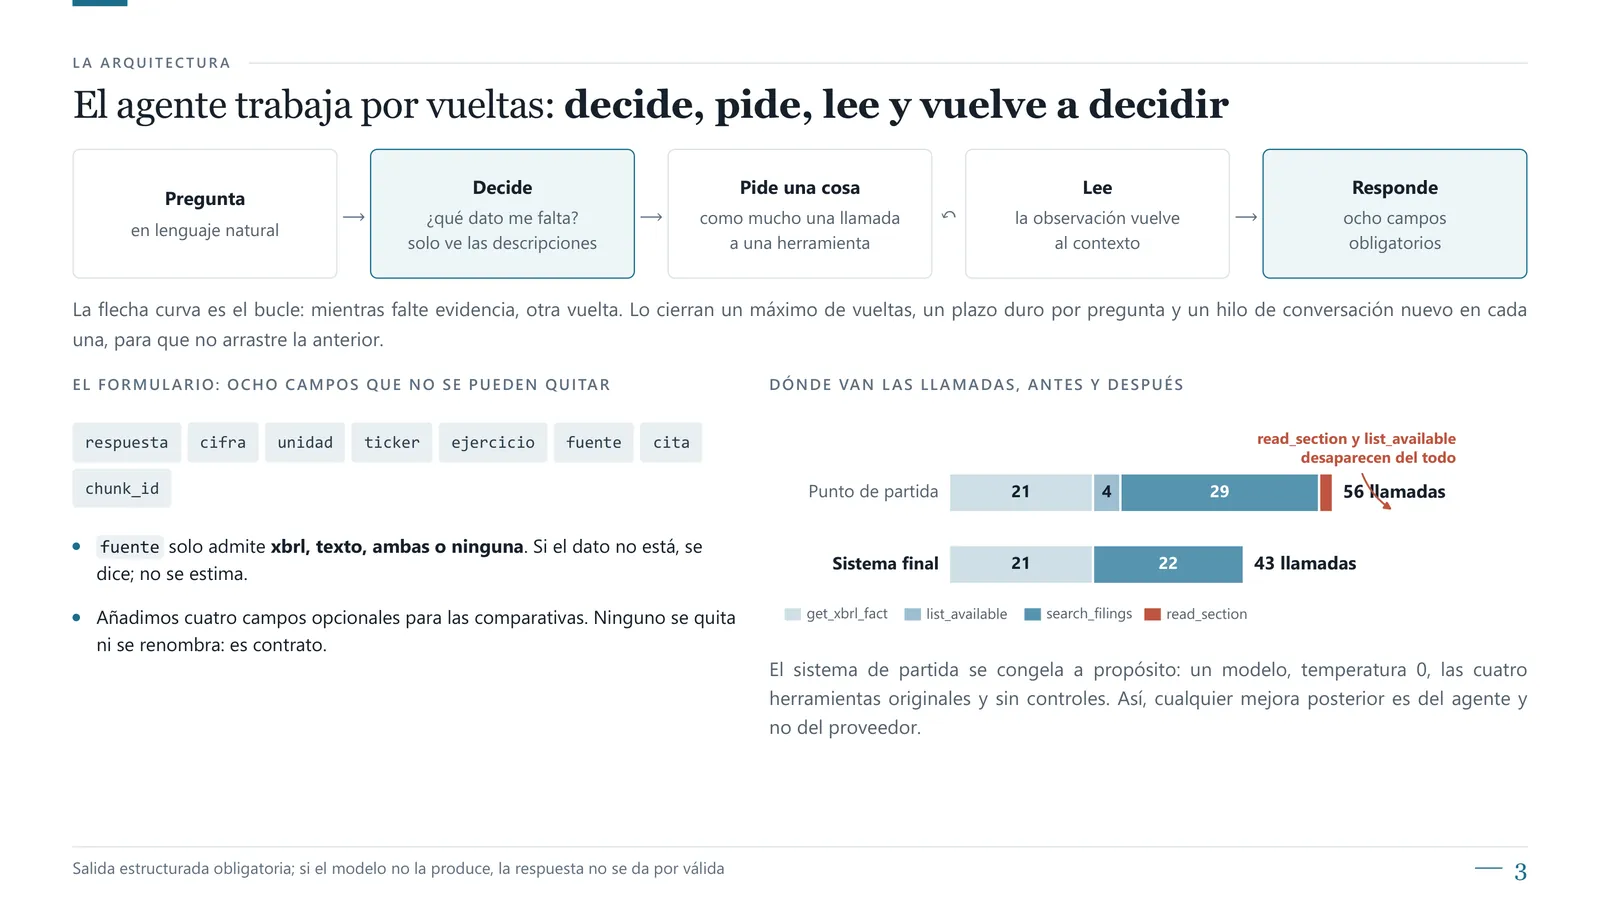
Responder preguntas financieras sobre los informes 10-K de NVIDIA, Microsoft, Apple, Alphabet, Meta y Amazon de los ejercicios 2024 y 2025, citando la fuente exacta. Un modelo solo se inventa cifras o cita el año equivocado. El agente de partida, con búsqueda densa y nada más, acertaba el 35 % de nuestras preguntas.
Cómo está hecho
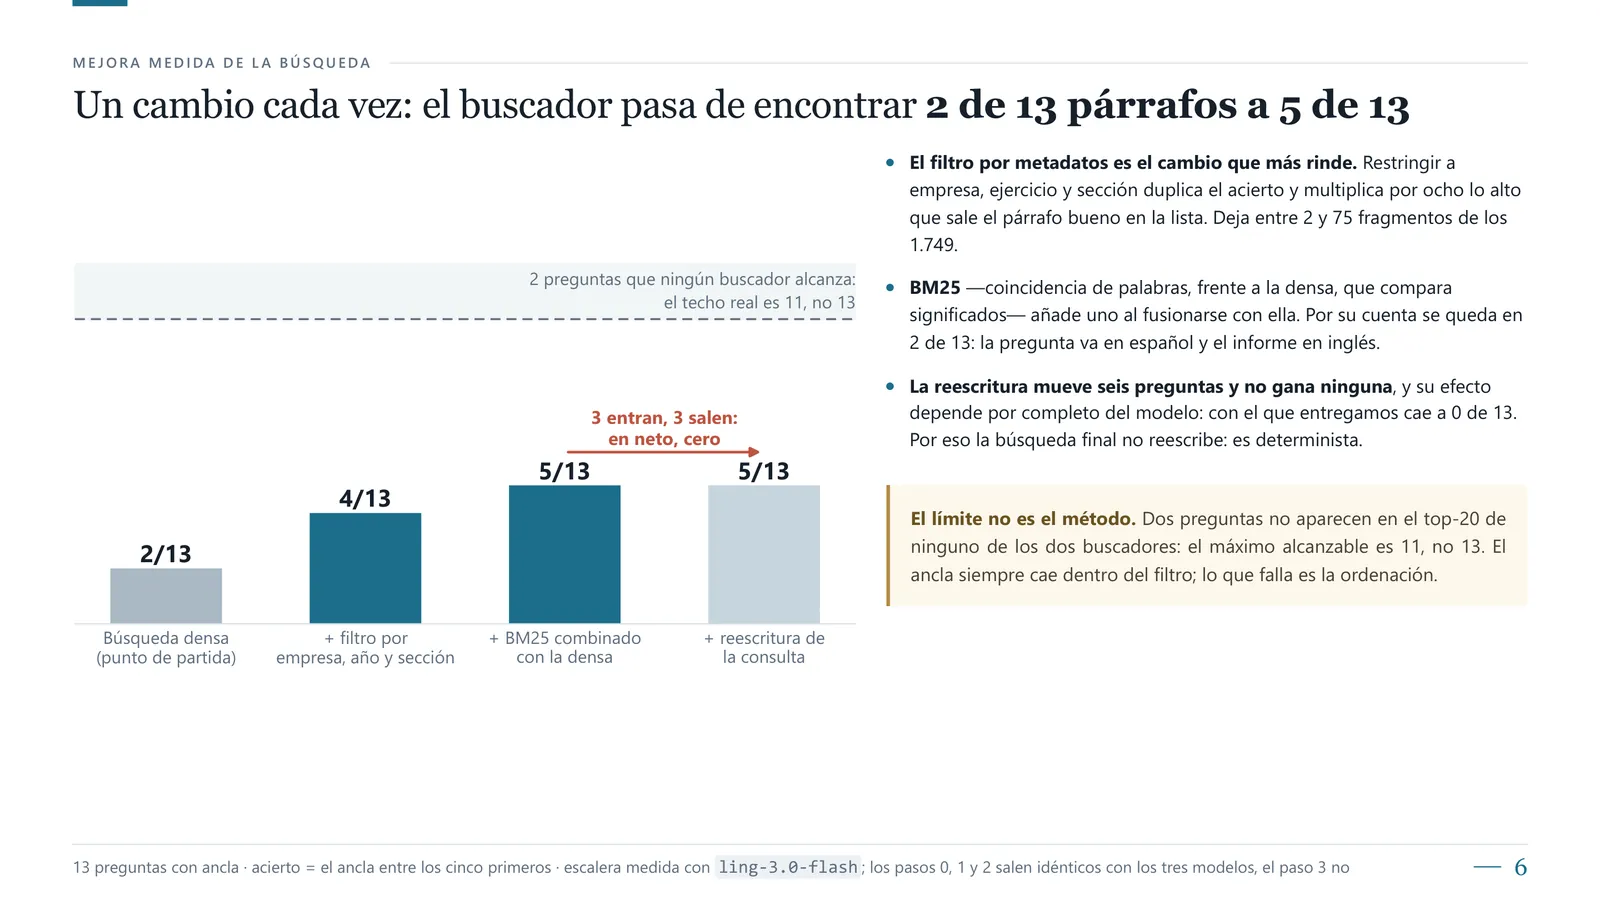
Cuatro herramientas sobre los hechos XBRL y el texto de los informes, con una escalera de búsqueda medida paso a paso: filtros por empresa y ejercicio, BM25 combinado con vectores mediante fusión de rankings y reescritura de la consulta. Encima van las salvaguardas: un límite de llamadas, la comprobación determinista de cada cifra contra XBRL, una cita por cada frase numerada, una fuente sacada de lo que el agente recuperó de verdad y un paso de reparación cuando falta la respuesta estructurada.
Escribimos nuestro propio conjunto de referencia: 20 preguntas numéricas, extractivas y comparativas, y otras 6 en las que la respuesta correcta es que el dato no está en los informes.
Resultados
Con el mismo modelo en las dos ejecuciones, el acierto pasó del 35 % al 65 %. Las comparativas pasaron de 0 de 7 a 4 de 7, con menos llamadas por pregunta (de 3,3 a 2,2) y prácticamente el mismo coste. En las diez preguntas a ciegas que entregó el curso acertó 8, en unos 15 segundos cada una.
Lo que aprendí
La temperatura 0 no es determinista con todos los proveedores. Una réplica de una ejecución bajó del 75 % al 60 % con el mismo código y el mismo modelo; sin ella habríamos presentado un 75 % que no se sostiene. También detectamos un error nuestro: una comparación mezclaba dos commits, así que cambiaba tres variables en lugar de una. Ahora comprobar el commit de cada ejecución forma parte del protocolo.
Figuras